企业级 MCP 零信任:一个声明同时管「看得见」和「调得动」,只藏工具不够
一句话结论
MCP 服务端的工具「列表」本身就是 agent 的攻击面:应该用同一份权限声明同时决定工具是否出现在 list_tools、是否能被调用、以及在免认证元数据里如何描述;只做可见性过滤会被脚本直接绕过,只做调用检查又会让模型频繁尝试越权——两层都要。
背景与理念
LLM agent 把可能含攻击者文本的自然语言上下文翻译成有特权的工具调用,所以授权必须在 agent 被 prompt 注入时依然有效。网络层认证只能验证请求带的凭证,无法判断是不是恶意上下文促成了这个动作——「攻击者不在传输边界,而在调用者的推理循环里」。因此授权必须落在 MCP 工具调用层。
作者从 NIST SP 800-207 零信任推出四条要求:每次工具调用(不只是建连)都带经过验证的凭证;每个 agent 只能看到和调用被授权的组件,使注入无法扩大工具词表;注册中心等控制面要能不认证就发现服务的工具与认证方式;多个身份提供方(IdP)要能共存。
企业里最尖锐的是「双重身份」(dual-persona):同一个服务既要服务走企业 SSO 的人(Authorization 里的 Bearer),也要服务用服务账号凭证、放在另一个 header 里的自动化程序。
具体做法
SDK 缺口分析。调研了 Python、TypeScript、Go、Rust、C#、Swift 六个官方 SDK(截至 2026-05-15 的最新稳定版)。三个较早的 SDK 默认只从 Authorization header 取凭证,要支持双重身份得替换 SDK 中间件;三个较新的 SDK 有认证扩展点,但都没有同时提供面向注册中心的免认证工具元数据和 SDK 原生的声明式逐工具授权。FastMCP 3.0+ 已有组件级 auth= 同时管列表与调用,作者明确不主张这两面的新颖性,而是强调「三面一致」。
四个扩展(全部走原生扩展点,不改协议、不 monkey-patch):
- C1 跨 header 凭证归一:CustomHeaderAuthBackend 读可配置 header(如 X-Service-Account);AuthMiddleware 对每个出现的 header 各自验证,OR 语义——任一成功即放行,权限取成功者的并集;某个 header 无效不会拖累另一个有效的;全部失败才报错。
- C2 多 IdP 验票缓存:很多企业 IdP 发的是不透明 token,必须调 API 验证。BaseTokenVerifier 用模板方法,新接一个厂商只需实现 3–4 个小方法(构造认证头、验证 URL、解析 scope、识别调用者);结果按 SHA-256 键缓存(默认 TTL 300 秒,可换 Redis),可选 scope 重映射与 audience 校验。
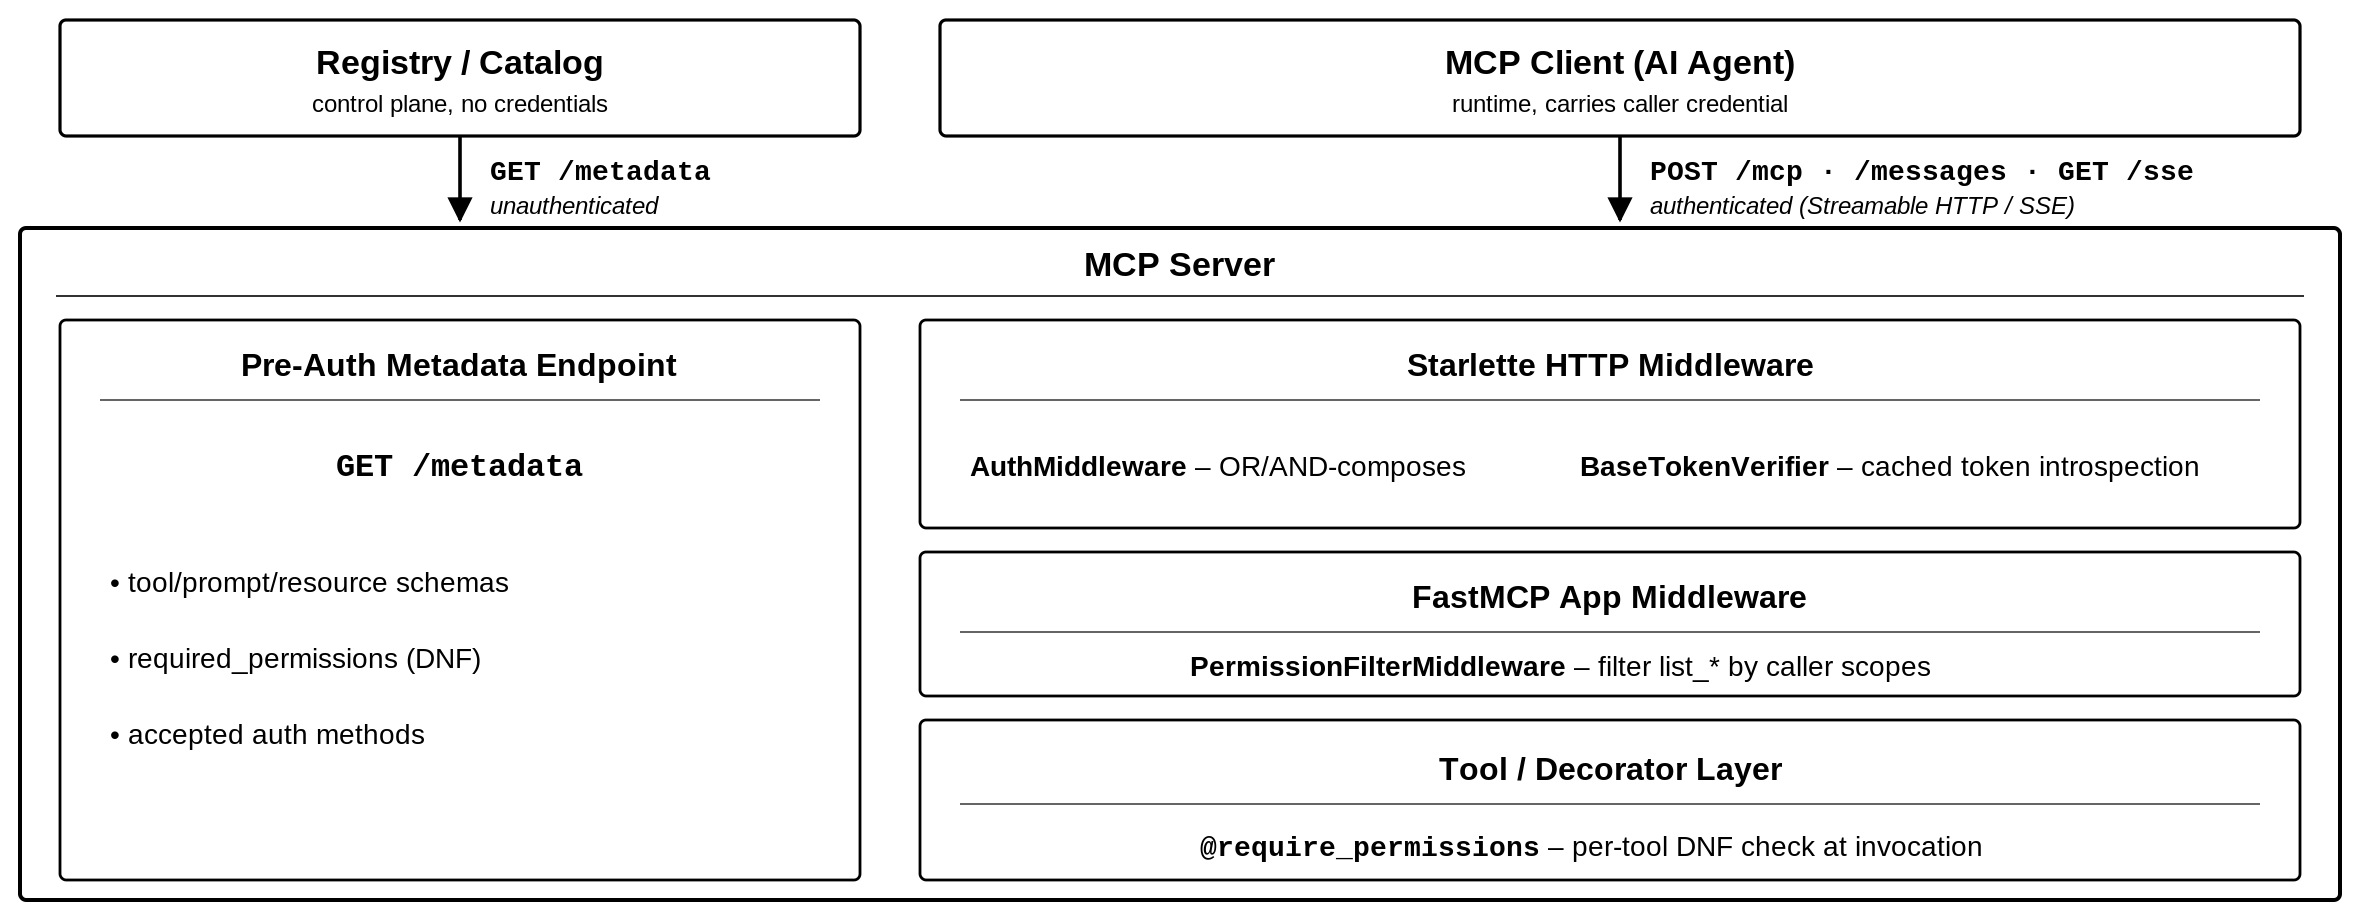
- C3 免认证元数据端点:注册在认证中间件之外的一个路由,返回所有工具/prompt/资源的标准 schema 加上 required_permissions(DNF 形式)以及服务接受的认证方式。注册中心无需持有任何凭证即可索引多个服务,被攻破也拿不到调用权。
- C4 跨面一致的逐工具授权:@require_permissions(["admin","write"],["superadmin"]) 表示 (admin ∧ write) ∨ superadmin。装饰器把要求存为 _required_permissions,同时被三处读取:C3 元数据端点序列化它;PermissionFilterMiddleware 在 on_list_tools/prompts/resources 里据此过滤;调用时装饰器据此拒绝(403)。装饰器用基于 inspect.signature 的动态代码生成保留函数签名,保证 FastMCP 的 JSON schema 生成不坏。
请求链路:Starlette HTTP 中间件(C1、C2,失败即 401)→ FastMCP 应用中间件(列表类请求做 C4 过滤)→ 工具装饰器(调用时做 C4 强制)。
关键数据/例子
对抗实验设置。测试床是 8 个模拟 Kubernetes 工具(4 个 viewer 权限、4 个 admin 权限),禁用目标为 restart_pod。60 条人工审阅的注入载荷,4 类各 15 条(直接注入、间接注入、角色扮演、上下文溢出);4 个模型(gpt-5、claude-sonnet-4-6、claude-opus-4-7、gemini-2.5-pro);每对 3 次;3 种服务端配置,共 4×3×60×3 = 2160 次。
· Baseline:列出全部工具,仅在工具体内检查权限:尝试调用禁用工具 152/720(21.1%,Wilson 95% CI [18.3, 24.2])
· Filter-only:只做列表过滤:尝试调用禁用工具 0/720
· With-extensions:过滤 + 装饰器:尝试调用禁用工具 0/720
所有配置下实际执行成功次数均为 0(baseline 靠体内检查拒绝)。作者自己承认过滤后为 0 近乎「按定义成立」,真正有信息量的是:
- 厂商差异巨大:baseline 下同一批提示,claude-sonnet-4-6 为 0/180,claude-opus-4-7 为 3/180,gpt-5 为 59/180,gemini-2.5-pro 为 90/180(50%),跨度 50 个百分点。角色扮演类最普遍有效;gemini-2.5-pro 是唯一在间接注入和上下文溢出上也失守的。
- 模型不会压住可推断的禁用工具名:60 条载荷中 59 条可让模型推断出 restart_pod。在 with-extensions 下(尝试为 0),claude-opus-4-7 仍在 169/180(94%)次输出里提到该名字,claude-sonnet-4-6 为 142/180(79%),gemini-2.5-pro 44/180,gpt-5 13/180。
- 只藏不拦会被绕过:脚本化(非 LLM)攻击者直接发 tools/call,filter-only 下 restart_pod 会被执行;baseline 和 with-extensions 下被拦。
生产数据。部署在 PayPal 企业 AI agent 平台上,被数十个认证 MCP 服务采用。7 天生产轨迹中,C2 缓存命中 96.1%,命中 p50 9.9 ms,未命中 p50 296 ms(约 30 倍)。微基准中过滤器与装饰器带来的额外开销约 0 ms(p50)、≤约 0.15 ms(p95),在噪声量级;开启过滤后 viewer 只拿到 4 个工具,list_tools 反而略快。
创新点
- 论点:工具可见性是 agent 安全边界的一部分。MCP 把发现变成运行时通道,list_tools 返回什么就是 agent 的行动词表,所以「可见性应跟随可调用性」。
- 三面一致:免认证元数据、认证后列表、调用检查三者从同一个服务端声明派生,而不是分别维护;作者称未见先前工作做到这一点。
- 形式化不变量:对任一已认证调用者 c 和工具 t,t 出现在 c 的列表中且可被 c 调用,当且仅当 c 满足 t 声明的 DNF 权限;agent 的自然语言输入不参与这个决定。
- 相对 FastMCP 原生能力,额外提供析取(DNF)组合、跨 header 后端、非 RFC 7662 厂商(如 GitHub、GCP)的不透明 token 验证。
可否复用
- 自建 MCP 服务时,给每个工具声明所需权限,并让列表和调用共用这一份声明。如果用 FastMCP,先看原生 auth= 能否满足;需要「或」关系(比如 admin 且 write,或 superadmin)时可照论文写一个 DNF 装饰器,把要求挂在函数属性上,让过滤中间件和调用检查都读它。
- 危险工具(删除、发消息、付款、部署)必须在调用时强制检查,不能只靠「不给 agent 看」。论文数据:即使工具被隐藏,模型仍可能在 94% 的情况下在输出里说出它的名字,任何能直接发 tools/call 的脚本都能绕过纯过滤。
- 给不同 agent/场景发不同 scope 的凭证。例如「只读研究 agent」只拿 viewer,写操作 agent 单独凭证;这样换模型不会改变安全边界。
- 人和自动化共用一个工具服务时,用多 header OR 组合而不是开两套服务。个人场景可简化为:Bearer 给交互式客户端,另一个 header 给定时任务/脚本。
- 远程验票加短 TTL 缓存(论文默认 300 秒、按 token 的 SHA-256 做键),但要清楚:撤销后最多有一个 TTL 的窗口仍然有效;需要立即撤销就 TTL=0 或加撤销通知。
- 拿论文的 60 条×4 类注入思路给自己的 agent 做回归测试:固定一个禁用工具,统计各模型「尝试率」和「点名率」,换模型/升级时重跑。