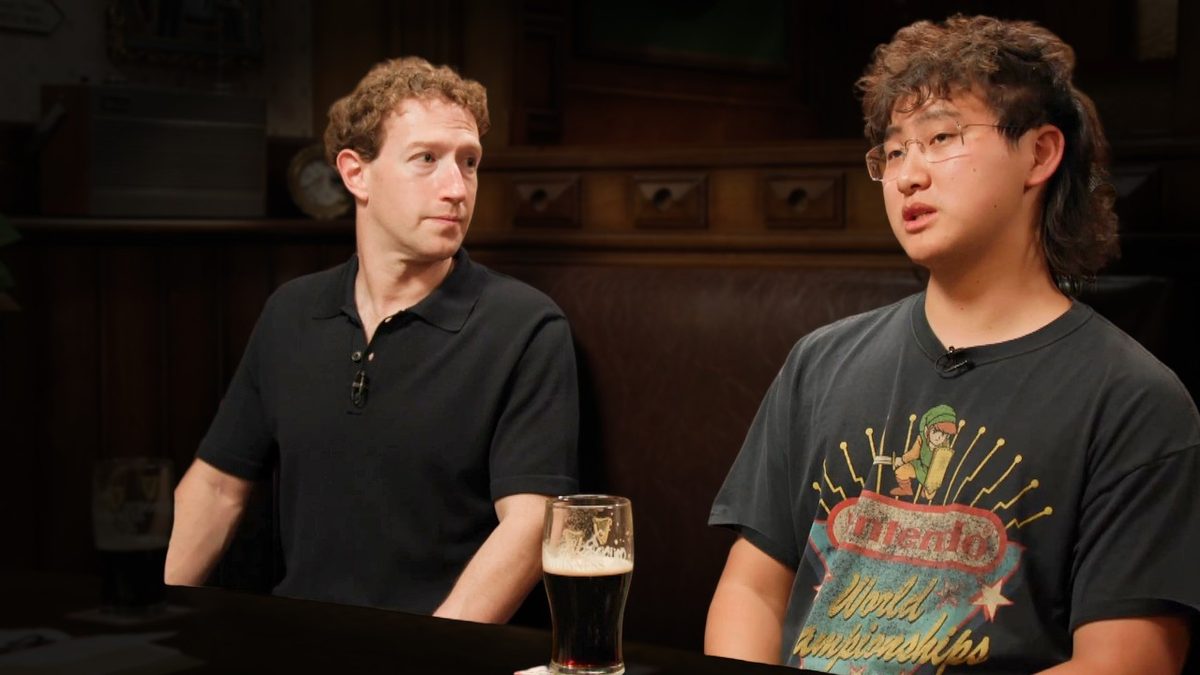
扎克伯格与 Alexandr Wang 上 Cheeky Pint:Muse Wonder 的「主动记忆」和「主动专注」怎么来,研究团队不到 200 人,以及在没见到模型前就签下千亿美元级投入
一句话结论
在两个多小时的对谈里,扎克伯格和 Wang 讲了 Muse Wonder 的定位(最适合个人与职业智能体的前沿模型)、主动记忆和长程任务坚持能力是写进模型而非外挂、为什么越来越依赖内部评测、预训练与 RL 各自的「科学」,以及 MSL 以不到 200 人的研究团队、每人大量算力的方式运作;扎克伯格还说一个吉瓦集群每年运营成本约 150 亿美元。
背景与理念
这期节目在 Muse Wonder 发布时录制,Meta 的 AI 基础设施正在扩展到 5 吉瓦以上。主持人 John Collison 开场说,从第三方报告看,Muse 可能是有史以来增长最快的智能体或 AI 应用。
两人反复强调的核心理念是「模型就是产品」。扎克伯格说产品层越来越薄,模型越来越成为产品本身;Muse 的大量产品工作在隐私和安全模型上,而能力和个性主要靠训练进模型。
具体做法
自己怎么用 Muse
扎克伯格最喜欢、也被他当作产品评测的用例,是让 Muse 在 MMA 训练回合间隙给他反馈。他在健身房装了摄像头,Muse 要在两回合之间的一分钟内处理完视频,它自己想出了抽帧的办法,实际上是在写一整套视频和图像处理流程;他会不断要求它「你花了 30 秒才给反馈,我只有 60 秒休息,再快点」,并说未来人人都会写大量代码,只是自己不知道在写代码。
另一个例子是他和三岁女儿每周末烘焙。他们一周里用语音模式和 Muse 讨论要烤什么,Muse 能区分两人的声音,并确保每周六需要的食材按时从 Instacart 送到;他说自己以前一年只用一两次 Instacart,现在为了给 Muse 用专门开了账号,每周用一两次。Wang 则让自己的 Muse 每周从台湾或日本的小茶园采购越来越冷门的茶。
Muse Wonder 的几项能力
Wang 介绍了几项重点:主动记忆、主动专注、领域专长和前沿编码。主动记忆指模型在几天、几周甚至几个月里记住你提过的事并用于后续任务,他强调这是模型本身的能力,模型知道自己的记忆系统并懂得怎样做压缩,不只是外挂的 harness;主动专注指在很长的任务里坚持下去,遇到挫折时以对齐的方式找别的解法。
领域专长方面,他说 Muse Wonder 在多项金融和法律评测上是最先进的,个人智能体应该让人感觉身后有一支法律、财务和医疗专家团队。编码方面,他说它在 DeepSWE 和 SWE-Marathon 上达到最先进水平,在 Terminal-Bench 4 等基准上表现也好。
Muse 里不提供模型选择器和推理力度选择器。扎克伯格说「我就是想让它简单」,Wang 吐槽有些 AI 产品的模型命名对普通用户太难懂。
评测:从外部基准转向内部基准
扎克伯格说外部基准饱和得太快,每发布一次,他们看的指标里内部评测的占比就更高。Wang 说他们在研究博客里量化了「大模型味」:比较模型在 RL 训练分布内和分布外任务上的表现差距,从 Muse Spark 系列到 Muse Wonder 系列,这个差距有大幅改善;他还说只盯外部基准,等于把产品思考外包给了某个做出爆款基准的博士生。
预训练与后训练
Wang 说预训练是风险最高、也最「科学」的环节,因为样本太少,只能靠缜密推理去推断结果,他们把很大比例的算力投进了 Muse Wonder 的预训练。扎克伯格补充:想让模型擅长某些领域,不能只在最后用 RL 灌进去,要在预训练阶段就让它接触大量相应数据,比如图像、音频、视频和健康类语料。
后训练分 SFT 和 RL。Wang 的比喻是 SFT 先把想要的行为初始化,结束时模型可能只在 10% 的情况下表现出来,RL 再把这些行为的出现率大幅拉高;他说 RL 里「数据少反而更好」的情况很常见,而且安全上要特别小心,如果 RL 环境里唯一的成功办法是做出不对齐的事,模型就会学坏,所以 Muse Wonder 的 RL 环境都经过精心筛选。扎克伯格说 Muse Spark 从 1.0 到 1.3 没有改预训练,只是持续加 RL。
对齐观
扎克伯格说 Meta 理解的对齐更偏向「与它服务的那个人的指令和价值观对齐」。你让它做事,它要高可靠地照做,而不是说教;真遇到灾难性请求,要「体面地、不惹你生气地」不做。他也提到「谨慎」这一能力,例如替你订餐厅时要照顾你的过敏或怀孕情况,却不必把病情告诉餐厅。
千亿美元的赌注与算力
扎克伯格回忆,去年底还没看到模型,就要签下大概 1000 亿到 2000 亿美元的投入,他问 Wang「你确定这能行吗?」Wang 说 CFO Susan Li 多次把他拉到一边,提醒如果模型不好,在财务上会非常非常糟糕;扎克伯格则认为风险没有表面上那么大,因为只要 AI 整体成功,别人都会想租他们的算力,即使 AI 整体失败,Meta 自己也有很多用途。
他说衡量一个实验室的算力实力,要看它最大的单台超级计算机。Meta 在俄亥俄的 Prometheus 集群规模超过 1 吉瓦,路易斯安那的 Hyperion 集群将扩展到 5 吉瓦,这些规划早在 2023 到 2024 年 Llama 时期就开始了。
MSL 的组织方式
扎克伯格说,Llama 4 在 2025 年 4 月 4 日发布后,他大约在 4 月 20 日前后开始四处打电话求教,最终决定「有时候你得重启一个团队」。Wang 的第一条建议是不需要很多人,关键是人才密度;扎克伯格说研究团队不到 200 人,更接近 100 人,另有一批基础设施人员,每个阶段的工作在 Meta 是几十人,而别家可能是几百人。
他们刻意保持扁平、没有非技术管理者。扎克伯格说研究者一旦离开细节就会很快变得不懂技术,所以人人都要保持技术性;他还说当时几乎清空日程一两个月,专门见研究者。
为什么没有赢家通吃
Wang 认为一个原因是领先者并不总能执行完美,另一个是蒸馏的力量,它让开源生态受益,能把很强的能力装进越来越小的模型。扎克伯格说他们认为好的安全格局是多样性和相互制衡,让很多不同的东西都可以被人使用,而不是少数几家公司握着几个好模型,后者在他看来风险更大。
关键数据/例子
扎克伯格给出的成本口径:运营一个 1 吉瓦集群一年大约 150 亿美元,前期资本开支大约 500 亿到 600 亿美元;Wang 说根据他看到的财务汇总,训练一个前沿模型要几百亿美元。
研究团队不到 200 人,扎克伯格说更接近 100 人;Muse Wonder 从去年 8 月就开始规划。内部代号方面,Muse Spark 系列叫 Avocado,Muse Wonder 叫 Watermelon。
分发方面,Muse Wonder 起初主要给付费订阅用户,同时通过 Meta Model API、OpenRouter 和 Muse Code 提供;免费用户继续使用 Muse Spark 的大量免费额度。扎克伯格说希望不久后有一个 Spark 体量、却和 Wonder 一样好的模型,用来服务数亿人。
创新点
第一,把记忆和压缩当作模型训练目标,而不是只靠外部 harness。这回应了主持人所说的 OpenClaw 类工具「记忆很容易出 bug」的普遍痛点。
第二,用「分布内与分布外表现差距」来量化所谓「大模型味」,作为对抗刷榜的内部指标。
第三,组织上用极高的人才密度和每人大量算力替代大团队,并公开讲了从 Llama 4 失利到重启团队的决策过程。
可否复用
- 自建评测时,同时看分布内和分布外表现。两者差距越小,说明模型越不是在刷训练分布。
- 做 RL 或自动化奖励时,检查是否存在「只有违规才能成功」的环境。这类环境会把不良行为放大,应在设计阶段剔除。
- 面向普通用户的智能体产品,尽量隐藏模型和推理档位选择。把选择权留给系统,减少理解成本。
- 代办类智能体要训练「谨慎」。它需要知道很多关于用户的信息,却在对外办事时只披露最少的必要信息。