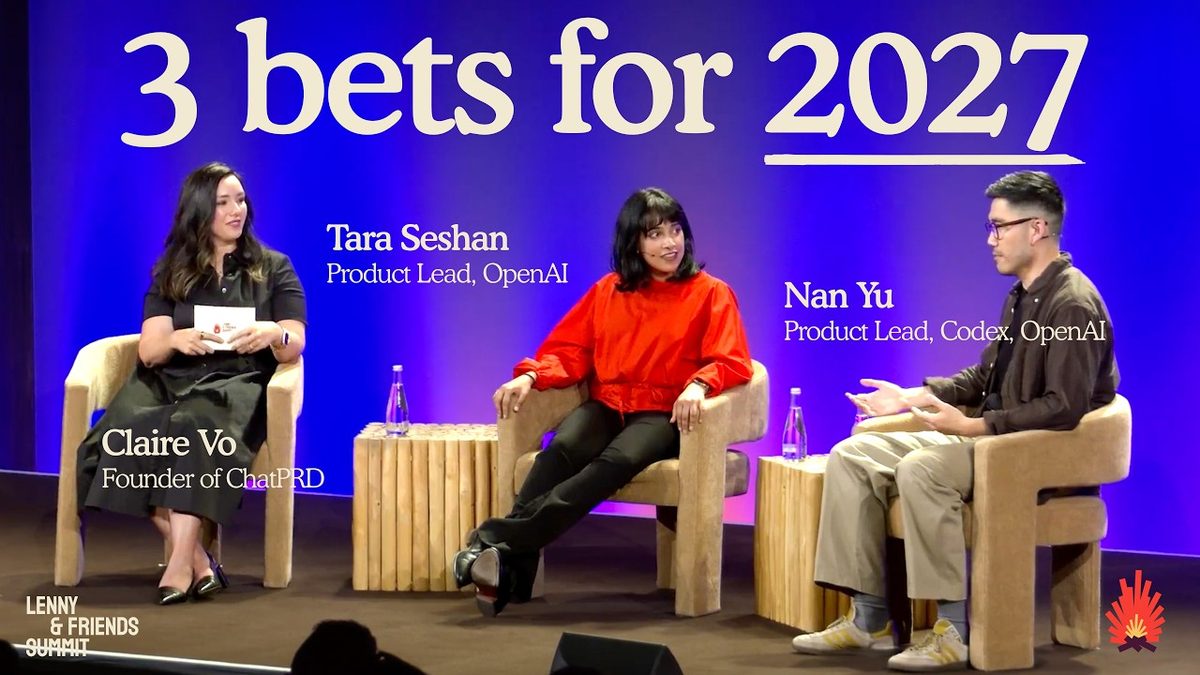
OpenAI 的 Codex 与 Work 产品负责人:别再做 2027 年规划,只看两到三个月后的模型;「切换开关」不完美但把智能体送到了十亿用户面前
一句话结论
两位负责 Codex 和 Work 的 OpenAI 产品负责人讲了他们怎么在模型飞速变化时做产品:ChatGPT 里的「切换开关」是一个不完美的方案,但它让十亿多用户用上了智能体,又不打乱开发者的工作流;上线门槛是能带来新增价值、内部试用有人持续用、能解锁模型的新用法,并瞄准两到三个月后模型的能力;最大的约束不是模型,而是人吸收变化的能力;和研究团队合作要带着具体用例、真实会话和评测;规划只看两到三个月,Tara 还专门留了一份「预测错了的事」文档提醒自己。
背景与理念
这场对谈录制于 2026 年 9 月 10 日的 Lenny & Friends Summit,主持人 Claire Vo 开场就问 ChatGPT 里那个把聊天和智能体分开的「切换开关」。Tara Seshan 在 Stripe 工作了大约七年,她说那里的一切都要深思熟虑、反复打磨,连枚举值怎么命名都要想很多遍;来到 OpenAI 后最大的变化是:紧迫性真的很重要,而且上线前的推演再多,也比不上看到用户真的去用、再迭代。
她承认切换开关不是理想方案,但关键是把智能体执行能力交到使用 ChatGPT 的十亿多用户手里,同时不打乱开发者的工作流。Nan Yu 补充,下一步显然是不再需要开关;只要有一条用户能跟上的连贯故事,并让他们了解背后发生了什么,用户对产品演变的接受度会高很多。
具体做法
上线的门槛
Tara 说她看几件事:是否给用户带来新增价值;内部试用时有没有足够多的人用起来、是否留得住、是否有让人惊喜的地方;是否解锁了模型的新用法。最重要的一条是瞄准两到三个月后模型的位置,既不过度锚定现在,也不做得太超前而不能用,她称之为足够「AGI 化」的那个区间,同时要给模型让路,让它发挥。
Nan 说最大的约束其实是人们理解和吸收变化的能力。大家常说「能力过剩」,模型能做很多,但人们没有用上;不管你放进去什么,如果人们吸收不了,这才是真正的上限。
Claire 问企业客户是不是真的吸收不了变化,Tara 说当前节奏对多数企业来说确实超过了「疯狂」,但不给企业最新的前沿能力,就会被对手跨越。她举例说,大多数企业客户原本只是用聊天问答,而智能体革命正在发生,OpenAI 必须尽快把智能体交给他们,否则他们会考虑别的产品;所以哪怕会打破企业原有流程和对更新方式的预期,也要发布这个巨大的变化。她的总结是那句老话:做用户需要的,而不是用户说他们需要的。
一个智能体还是很多个
Claire 说自己既有整天对话的 Codex,也有在业务各处承担工作的 40 个机器人,问该集中成一个通用身份,还是做很多小智能体。Nan 说最成功的设计都在贴合人性:问任何人愿不愿意管 40 个直接下属,大多数人都会犹豫;人们管理很多智能体时,往往先设一个「幕僚长」智能体去管其他的,「你这就是作弊,你管的不是七个,而是一个」。所以要把智能体按活动打包。
Tara 认为这个问题有哲学的一面,但更多是具体的产品问题。比如数据访问和权限怎么处理,一个智能体是在用服务账号还是你的账号,怎样让用户容易理解;单一智能体是否要分段记忆,每加入一个私密 Slack 频道,它是不是就成了一个「被切割」的不同智能体;它该用每个人自己的凭据还是一套通用凭据。她说,最终要看具体用例和各种边界情况。
需要哪些能力
Nan 说系统思维和用户同理心都是经典的 PM 能力,只是要用在一个全新的技术世界里,从原则出发重新思考产品该长什么样。Tara 加了第三项:不屈不挠地去试、不断迭代,并愿意承受其中的痛苦,以及从反馈循环中学习的能力,只是现在的节奏快了很多。
平台分层:插件优先,电脑操作兜底
Tara 说他们把 ChatGPT 看作一个平台,思考哪些功能原生放进来,哪些让第一方或第三方以插件或界面的形式接入。例如,需要给第三方会议应用开放哪些钩子,让它在 Codex 里配合电脑操作和其他工具发挥作用。她不认为这是二选一:可以先有插件拿到会议数据,判断你下一步要做什么;如果这些系统接不上,还有电脑操作作为下一层兜底。能力按层组织、以钩子形式开放、彼此可组合,最终服务于用户完成任务。
Nan 说,完成整件事和只差最后一公里之间差别巨大,最后一公里没做完,有时比根本做不了更糟。做不了你会自己动手或换条路;做到 99% 却突然崩掉,是更糟糕的落空。他说电脑操作很多时候让人觉得好,是因为它总能做完,可能慢一点、花更多 token,但能把事做完。他引用查尔斯·伊姆斯的话:用户应该像你家里的客人,你已经预料到他们想做什么,并温和地为他们准备好。
怎样和研究团队合作
Tara 说来 OpenAI 前她从没和研究团队合作过,第一个体会是和研究合作不同于和工程合作。她的方法是带着非常具体的用例和用户目标,以及真实的会话样本:会话长什么样、模型为什么没做到;能写评测就尽量写,学会写好评测是最重要的;如果能证明「用这个提示和这些 skill 能达到效果」,就可以拿去和后训练团队讨论,怎样把这种能力训练进模型。她说要先获得研究团队足够的信任,才能自己写评测、把迭代循环转起来。
只规划两到三个月
被问活在多远的未来,Tara 说理想是两到三个月,不能太宏大地预测几年后,因为那些预测几乎总是错的。她有一份个人文档,专门记录自己预测错了、没有发生的事,用来提醒自己预测不了几年后的事;但只为今天构建又会被甩下。Claire 现场问观众谁在做 2027 年年度规划,Tara 补充说,这取决于所在市场:Stripe 所在的支付市场动态和过去大体相似,可以做牛市、熊市和基准情景,规划很多个月是合适的,而 OpenAI 的业务做不到这样。
现在的「入场门槛」
Nan 认为现在比以往重要得多的是新用户引导,因为能力过剩,如何让人一开始就理解你的产品能做什么,要持续投入,尽管很多工程师并不爱做这件事。Tara 认为用户对隐私和数据使用的理解比以往更重要;过去产品有点不可预测还能靠设置菜单或弹窗补救,现在智能体半自主地做事,必须让用户在任何时候都能预测一个功能会发生什么。其他老规矩照样适用,只是要更快、更依赖实证测试。
Claire 提到 OpenAI 的产品和工程团队在公开 Slack 里很容易被私信找到,问「可私信的 PM」是否成了标配。Tara 说她做开发者和企业产品出身,一直是可以被直接找到的 PM;对研究团队来说,你的价值就在于知道用户具体想做什么。Nan 说做智能体和自然语言界面时,问题往往很微妙,比如觉得 Astra「有态度」,需要追问它到底说了什么、上下文是什么,所以和用户更直接、更深入的关系会带来很多收获。
2027 年会火的东西
Tara 押语音:她说语音改变了她的工作方式,也大大减少了她给家人当技术支持的次数,她在给 OpenAI 人力团队上手一个新产品时,语音也起了决定性作用。Nan 押「自动驾驶式」的产品:解决空输入框问题,让产品自己用起来,帮用户温和地上手。Claire 押能替代随身打开笔记本电脑的硬件,比如「盒子里的 Codex」。
关键数据/例子
录制时间:2026 年 9 月 10 日,Lenny & Friends Summit。
ChatGPT 的切换开关让十亿多用户能用上智能体执行能力,同时不打乱开发者工作流。
上线门槛:新增价值、内部试用的使用和留存、解锁新用法,并瞄准两到三个月后的模型能力。
Claire Vo 自己的配置:一个常驻 Codex,加上 40 个分布在业务各处的机器人。
Tara 在 Stripe 工作了约七年,并保留一份「预测错了的事」个人文档。
和研究合作的四样东西:具体用例、真实会话样本、评测、可复现效果的提示加 skill。
创新点
第一,把「人吸收变化的能力」当成产品的硬约束。这解释了为什么新用户引导、可预测性和隐私说明会比以往更重要。
第二,用分层的能力栈应对生态不完整。插件和专用接口优先,电脑操作兜底,保证任务能做完,避免「99% 然后崩掉」。
第三,PM 与研究合作的具体路径。从真实会话到评测,再到可复现的提示和 skill,最后进后训练,这是一条产品人可以直接借鉴的工作流。
第四,用「预测错误清单」校准规划周期。它让「只规划两到三个月」不是一句口号,而是建立在对自己预测能力的记录上。
可否复用
- 用两到三个月的视野做路线图:把长期规划改成假设清单,每季度对照模型变化重新排优先级。
- 记一份「我预测错了的事」:定期回看,判断自己能可靠预测多远。
- 为智能体设计分层兜底:先用 API、插件或 MCP,接不上时再用电脑操作,保证任务完整完成。
- 向研究或模型团队反馈问题时附上真实会话和评测:比描述「模型不好用」有用得多。
- 设计多智能体时贴合人的管理习惯:按活动打包,不要让用户同时盯几十个线程。
- 把新用户引导当成核心功能:能力越强,越需要在第一次使用时讲清楚它能做什么、会做什么。