JAZ:只留一个 invoke 原语,让 agent 靠写代码自己长出「记忆」和「自我改进」
一句话结论
不需要专门的记忆系统或自改进流水线:只要让模型在 REPL 里写代码、能递归 invoke 子代理,并且把「用户提示 + 自己的交互历史」都当作可编程访问的变量,单靠提示词就能在长程回忆和持续自我改进两类任务上追平甚至超过专门设计的 harness,而且成本更低。
背景与理念
现代 agent 基本都建立在「agent loop」之上:模型调用工具、看输出、再决定下一步。ReAct 让模型每步自由选动作;CodeAct 更进一步,让模型在 REPL 里写可执行代码来编排工作流;RLM(Recursive Language Models)证明了「CodeAct + 子代理」在不借助外部工具的情况下,就能在长上下文任务上胜过直接用长上下文模型。
但长程记忆(比如 Letta/MemGPT)和持续自我改进(比如 ACE)目前仍然依赖在 agent loop 之外叠加专门的外部 harness。作者想回答的问题是:一个几乎只剩 agent loop 本身的极简 harness,能不能直接做到这些专门系统做的事?
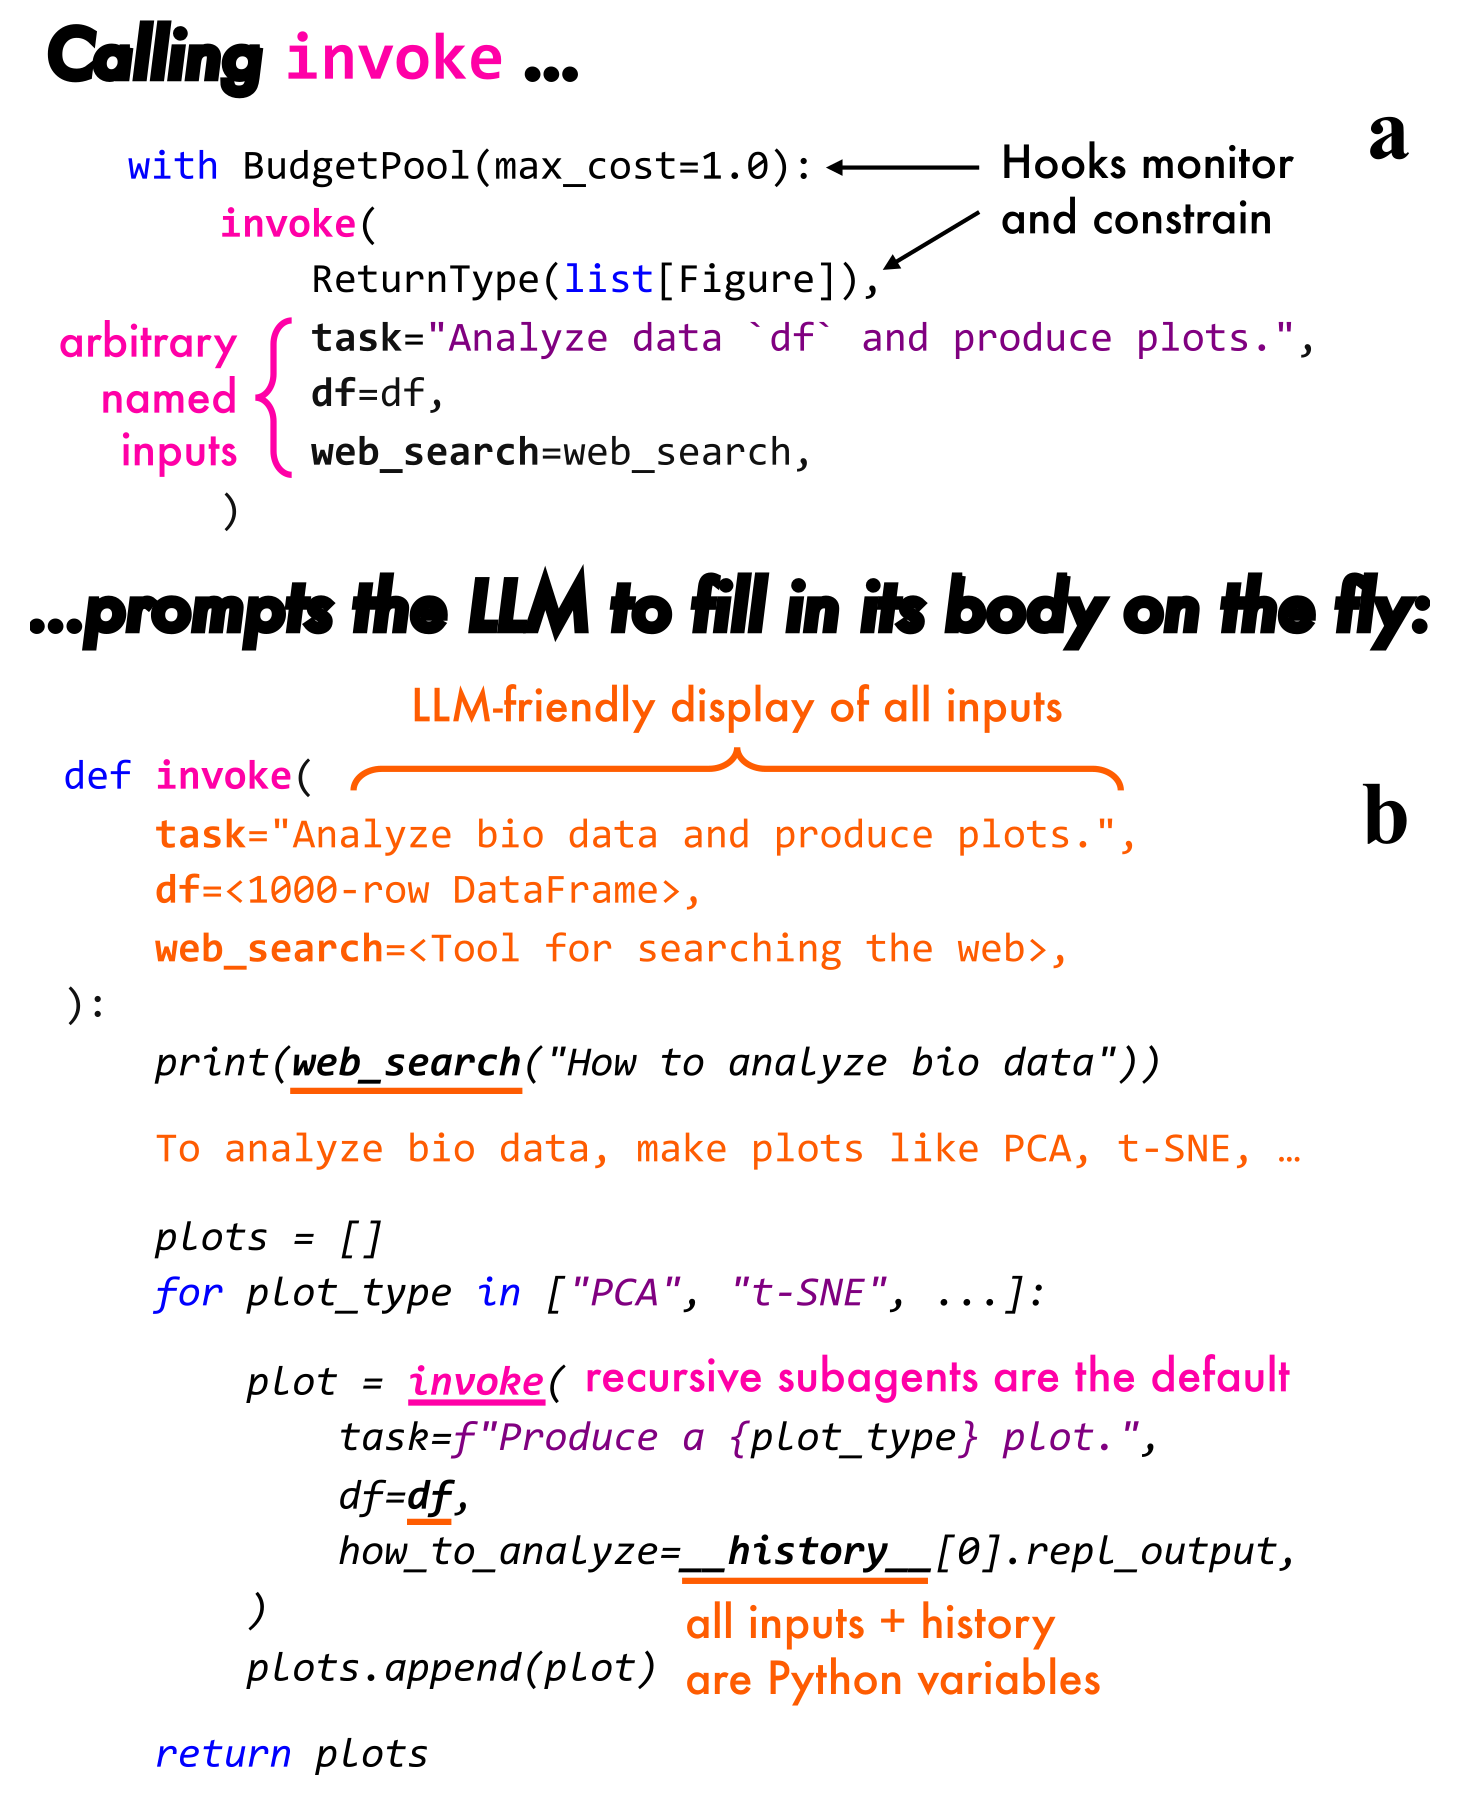
他们从编程语言的第一性原理出发:给任意图灵完备语言加一个新原语 invoke——它是一个「函数体在每次调用时由 LLM 现场生成」的函数。接受任意命名参数(数据、任务说明、工具一视同仁),返回任意对象。尾递归调用 invoke 自然就诱导出一个 agent loop;工程上由 harness 自动追加尾调用并做尾调用优化,最终就是一个 code-mode 的 REPL 循环。
由此得到 invoke agent loop 的两个定义性质:
1. 模型写的是「已包含 invoke 的语言」:所以默认就能在代码里递归调用 invoke(称为 sub-invoke),子代理是默认能力,工具和子代理都通过普通程序控制流编排。
2. 模型看到的一切都是 REPL 里的变量:包括所有输入(提示词和工具同等对待),以及 REPL 交互历史本身(__history__)。这一点是它与 smolagents、RLM 等现有 code-mode agent 的关键区别——后者只把用户提示和历史当作展示给模型的消息列表,而不是模型能用代码操作的对象。
具体做法
1. 核心原语与动态作用域。框架核心就是 invoke(**inputs)。另有 scope(Python 上下文管理器),在其作用域内的所有 invoke 及其递归子调用都能自动拿到这些变量——最常见的用法是把一个工具同时开放给顶层 agent 和所有子代理。论文特意说明:因为 invoke 没有静态实现、每次调用都生成新实现,所以只有动态作用域才合理。
from jaz import invoke, scope
with scope(web_search=web_search):
invoke(task="Use subagents to find 100 agent framework papers.")
2. Hooks 做约束与监控。内置 hooks 分四类:
- 可观测性:PrintLogger、FileLogger、TrajectoryRecorder、LangfuseTracing、JaegerTracing
- 可恢复:TrajectoryRecorder、TrajectoryReplay
- 资源控制:BudgetPool、IterationLimit、RecursionLimit、BudgetForcing、ContextWindowWarning
- 校验:ReturnType、ValidateReturn、ValidateREPLCode
hook 可以是局部的(作为位置参数传给某次 invoke,只管这一层)或作用域的(用 with 激活,管所有子调用)。例如 with BudgetPool(max_cost=5): 让作用域内所有 invoke 共享 5 美元预算,而 invoke(ReturnType(float), ...) 只约束顶层返回类型。自定义 hook 挂在 InvokeEnter/Send/Complete/Exit、LLMQuery*、REPLExec* 等事件上,只能发出可组合的「效果」,多个 hook 的效果统一合并、冲突则报错;hook 之间可通过 blackboard 通信。
3. 配置。Config(llm, repl, protocol),protocol 负责模型输出与 REPL 之间的衔接。默认把模型的整段原始回复直接当代码执行(自然语言写在注释里),REPL 输出过长则截断。ConfigOverride 同样有局部/作用域两种用法,可让顶层用大模型、子代理用小模型。
4. 长程回忆:尾递归委派。当上下文快满(实验中用 ContextWindowWarning 在上下文 70% 满时注入提示),agent 把剩余任务整体委派给子代理,并按引用无损传入完整历史:
return invoke(
instructions=instructions, guidance=guidance,
prev_history=globals().get("prev_history", []) + __history__,
state=..., prev_progress_summary="So far, ...",
next_steps="Your next step is to ...",
)
子代理需要回忆时,就在 prev_history 里用普通字符串查找并打印命中位置前后的窗口。论文指出,这一模式涵盖了多种上下文管理:只传 summary 就是 compaction;传过滤后的 __history__ 就是自动化上下文管理。
5. 持续自我改进:顶层即 meta-agent。顶层 invoke 控制传给子 invoke 的全部输入(提示词、技能函数),于是天然可以当 meta-agent:分批派发任务给子代理、要求子代理返回 (answer, __history__)、读失败轨迹、改提示词和技能、根据表现调整批大小。提示词里只描述工作流,不给代码模板。
关键数据/例子
StuLife(长程 + 远程回忆)。模拟大学生一学期的 1284 个有序任务,其中 939 个计分、207 个属于「远程回忆」(需要回忆 50 个任务以前给出的信息)。一次完整运行约 7000–8000 次环境交互、3000–5000 次 LLM 调用。所有方法均用 GPT-5.4 nano(high),3 次独立运行取均值±标准误:
· CodeAct(逐任务,无记忆):全部 Pass 52.5%;远程回忆 Pass 24.8%;成本 $4.4
· CodeAct+subagents(smolagents):全部 Pass 30.2%;远程回忆 Pass 20.6%;成本 $9.4
· CodeAct+subagents(JAZ 重实现):全部 Pass 60.0%;远程回忆 Pass 32.0%;成本 $13.1
· Letta Agent(MemGPT 新版):全部 Pass 70.9%;远程回忆 Pass 61.8%;成本 $42.1
· JAZ invoke:全部 Pass 72.6%;远程回忆 Pass 69.9%;成本 $18.3
即远程回忆子集约 70% vs Letta 约 62%,成本不到 Letta 的一半(摘要表述为「高 8%,成本一半」)。案例分析:第 1282 题是期末考选择题,正确选项依赖第 785 题(497 个任务之前)讲的虚构协议。JAZ 某次运行到这里时已递归深度 70、完成 69 次尾递归委派,但完整历史一直按引用传递,它用一轮在 prev_history 里搜协议名,下一轮答对;三次运行全对。CodeAct+subagents 因为每次委派都要手抄提示词,几十次后「要去搜历史」的指令丢失,凭常识答错;Letta 的 conversation_search(关键词+向量混合检索)不支持精确子串匹配,只在三次中答对一次。
AppWorld(持续自我改进)。test-challenge 全部 417 个任务(seed 42 打乱)按顺序给出,每题有完整测试反馈。求解 agent 均为 GPT-5.4 nano,meta-agent 为 GPT-5.4;自改进方法跑 6 次:
· AppWorld 官方 CodeAct(逐任务):TGC 48.2%;SGC 20.4%;成本 $16.6
· CodeAct(JAZ,逐任务):TGC 67.5%;SGC 43.4%;成本 $10.2
· CodeAct+subagents(JAZ):TGC 71.1%;SGC 47.6%;成本 $21.6
· ACE on CodeAct:TGC 69.9%;SGC 47.1%;成本 $30.6
· JAZ invoke:TGC 74.2%;SGC 51.1%;成本 $20.9
ACE 的 reflector/curator 每题成本约为 JAZ 的 10 倍;若每题都跑全在线 ACE 估计超过 $180,因此作者只让 ACE 在前 42 题(10%)上学习再冻结,即便如此总成本仍高于 JAZ。JAZ 6 次运行中有一次离群(TGC 64.5%),中位数为 75.2%。
创新点
- 把 harness 当语言原语来设计:将 invoke 形式化为「运行时由 LLM 提供实现的函数」(附录给出 lambda 演算上的形式语义),从而把 agent loop、子代理、记忆、自我改进统一到一个原语下。
- 「历史即变量」:__history__ 和用户提示是 REPL 变量,子代理可以按引用接收、调用方可以直接拿回子代理的完整轨迹。论文把这概括为:能按引用传递就比手工复制内容更可靠。
- 以 hook 而非固定流水线来施加约束:预算、递归深度、返回校验、上下文告警都通过可组合的 hook 实现,局部/作用域两种粒度。
- 严谨的对照设计:CodeAct 与 CodeAct+subagents 在 JAZ 内重新实现,只通过一个 hook 去掉「提示词/历史变量」,其余提示词逐字节相同,作为受控消融;并规定方法提示必须与任务无关、环境提示必须与方法无关,避免把任务知识泄漏进方法提示。
代码链接
可否复用
- 把「会话历史」做成 agent 可编程访问的对象,而不只是塞进上下文。自建工作流里,可以把每轮的 (代码/动作, 输出, 异常) 以结构化列表存下来,并在 REPL 或工具里暴露为变量。需要回忆时让 agent 用精确字符串/正则搜,而不是只依赖向量检索——论文的失败案例恰恰是向量/混合检索找不到精确协议名。
- 用「尾递归委派」替代简单的上下文压缩。上下文快满(比如 70%)时,让 agent 生成一个新的子会话,传入:原始指令变量(按引用,不要手抄)、完整历史引用、一段进度摘要、下一步计划。关键是指令和历史都「按引用」传,避免多次委派后指令漂移丢失。
- 预算与深度用 hook/中间件统一管。给所有子代理共享一个美元预算池、限制递归深度、对返回值做类型/格式校验、上下文告警——这些做成可组合的横切逻辑,而不是写进每个提示词。
- 自改进可以很朴素:meta-agent 分批派任务、读失败轨迹、改提示词和技能函数。论文给出的 meta 提示值得直接借鉴:先用最小种子跑 ~5 个任务;表现好就加大批量、缩小改动;几乎全对就不改只验证;每个改动都要基于证据并在下一批验证,没帮助就撤回;不许针对单个任务的失败形态打补丁。
- 大小模型分层。顶层 orchestrator 用强模型,子代理用便宜小模型(论文 GPT-5.4 + GPT-5.4 nano),成本明显下降。
- 评测习惯:做受控消融。比较两种 agent 设计时,尽量只改一个变量、其余提示逐字一致,并把「任务专属知识」挡在方法提示之外;多次运行报均值和离散度。