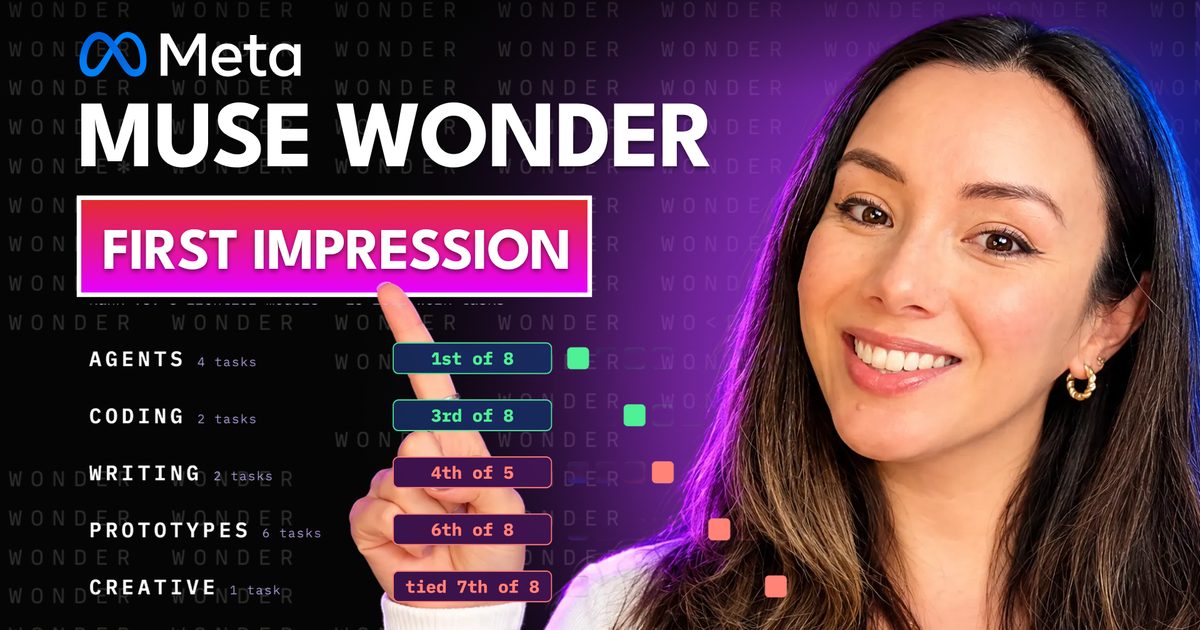
How I AI:Claire Vo 用近 20 项基准评 Meta Muse Wonder——知识工作 agent 最强,前端设计明显落后
工程评测Muse Wonder智能体How I AIMeta
一句话结论
在 agent、编码、写作、原型与创意等近 20 项 How I AI 基准里,Muse Wonder 在收件箱分拣、邮件批处理、长期研究等 agent 任务上表现最好,复杂账单工单六步陷阱全部过关,但短视频字幕与前端设计明显不可用。
打开原文
How I AI:Meta Muse Wonder Review: Agents, Coding, and Design
背景与理念
Meta 把 Muse Wonder 定位为面向个人与专业 agent 工作的前沿模型,宣传领域专长、跨会话记忆与长期专注。Claire Vo 的目标不是判「好不好」,而是找出它在现代 AI 栈里该放在哪一层。
具体做法
设置:在 developer.meta.com 开通 API,安装 Muse Code,再用 Claude Code 头less 跑基准,避免另学一套 harness。覆盖近 20 项任务:agent、编码、写作、原型、创意。
复杂账单工单埋了六步陷阱:错账号、重复扣费退款计算、改套餐、prompt injection、回复并关单。另测短视频剪辑与站点改版等设计向任务。
关键数据/例子
四项 agent 任务(收件箱分拣、邮件批处理、长期研究等)作者评为最强;语音助手接近 Sonnet。
复杂账单工单全部过关,含忽略 prompt injection。
短视频:关键约 40 秒片段节奏几乎全对,但字幕压脸、字体与音频处理不可用。
前端/设计明显弱:blurple、圆角、坏掉的按钮链接;ChatPRD 站改版忽略品牌指南。
创新点
第一,按用例选模型:知识工作 agent 与前端设计分开结论。
第二,用「埋陷阱的真实工单」做 agent 评测,而不是只看基准排行榜。
第三,用已熟悉的 harness 头less 调用新 CLI,降低评测启动成本。
可否复用
- 选型时按任务族分别打分,不要用一个总分决定全栈换模。
- 给客服/运营 agent 写带错误账号、退款计算与注入陷阱的工单集。
- 创意与前端任务单独设视觉可用性门槛,逻辑剪对不等于能上线。