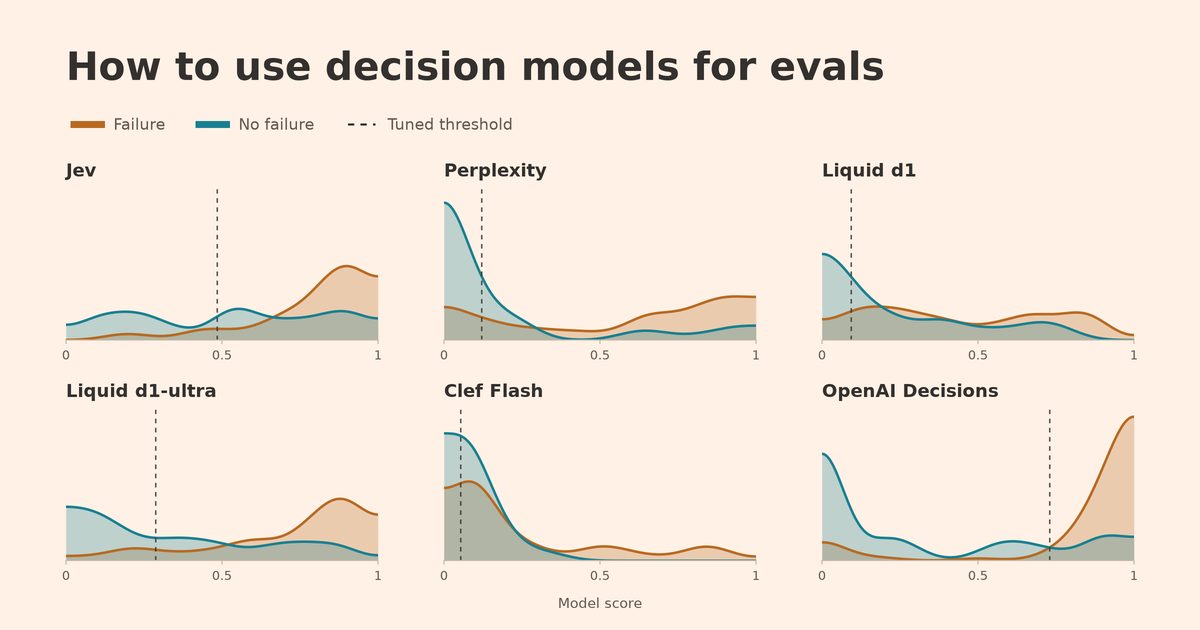
Hamel Husain 实测六个「决策模型」做评测:别用默认 0.5 阈值,先定精确率和召回率底线,再调阈值、看校准、比成本
一句话结论
作者用 100 条公寓租赁客服智能体的真实轨迹测试六个决策模型,发现直接用 0.5 默认阈值会白白丢掉效果:先设定精确率和召回率都不低于 80% 的业务底线,用交叉验证调阈值,再检查概率是否可信,最后才比较成本。
背景与理念
决策模型是最近冒出来的一类专做分类判断的模型,作者把它们看作 LLM 评审(LLM judge)的低成本替代品。文中列举的有 TypeSafe 的 Jev、Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef 和 OpenAI 的 Decisions API。
作者发现很多人拿来就用默认的 0.50 决策阈值,不检查它是否适合自己的任务,这会浪费不少效果。这篇文章的目的就是演示怎样调阈值、怎样比较成本与效果、怎样判断模型给出的分数能不能当作置信度。
具体做法
第一步是准备带人工标注的数据。作者用了 100 条公寓租赁客服智能体的生产轨迹(对话加工具调用),任务是找出包含错误的轨迹,比如预订失败或没有及时转人工;每个决策模型对每条轨迹输出一个「出错概率」。
第二步是先定业务底线,再看哪些模型能达标。作者假设这个分类器要用于自动告警,因此要求精确率和召回率都至少 80%,在精确率—召回率曲线上画出达标区域,结果只有 Perplexity、Liquid d1-ultra 和 OpenAI Decisions 三个候选进入达标区。
第三步是用分层五折交叉验证调阈值。阈值只在训练折上选,并且只选两项指标都达标的阈值,在留出折上报告效果;作者给出了可以直接交给编程智能体执行的提示词,要求复用已保存的分数、不重新调用模型,找不到达标阈值时如实报告而不是放宽要求。
第四步是检查概率校准。作者把分数相近的约 20 条轨迹分为一组,对比预测概率和实际失败率,并用 Platt scaling 做校正,同样给出了让编程智能体执行校准、报告 Brier 分数的提示词。
最后才把调好阈值后的 F1 和每百次评测的成本放在一起比较,画出帕累托前沿。
关键数据/例子
调好阈值后,Perplexity 是三个候选里最便宜的,每 100 次评测 0.82 美分,F1 为 0.79;OpenAI Decisions 的 F1 达到 0.87,每 100 次评测 3.72 美分,成本约为前者的 4.5 倍。
校准前后的差别可能很大。文中举例,Clef Flash 有一组轨迹平均预测失败概率约 8%,实际却有 60% 含有失败;Jev 和 Liquid d1-ultra 在这个数据集上本来就校准得较好,而 OpenAI 的概率用作者那版 Platt scaling 校正后反而略变差。
作者也强调结论只对这个数据集成立。他们观察到模型表现随任务和数据集差别很大,所以必须自己测。
创新点
第一,把评测分类器当作普通机器学习分类器来对待。作者坦言阈值、精确率—召回率权衡、成本效果比较都不是新东西,新意在于提醒大家别把决策模型当黑盒开箱即用。
第二,把统计步骤写成可复用的智能体提示词。调阈值和做校准都用「复用已保存分数、不再调用模型」的方式交给编程智能体完成,既省钱又可复现。
第三,先设底线再优化。先排除达不到最低精确率和召回率的模型,再在剩下的候选里比较,避免只盯着一个综合指标。
可否复用
- 给每个失败模式单独建一个评审,并先写清楚最低精确率和召回率要求。达不到底线的模型直接淘汰。
- 调阈值时用交叉验证,并且只在训练折上选阈值。不要直接用 0.5,也不要无脑优化 F1,可以按业务需要改用 F-beta。
- 如果要把分数当置信度用,先画校准图再决定是否做 Platt scaling。校正之后要重新测量,确认确实变好。
- 先用一个效果够好的大模型做基线,再试小模型能否以更低成本追平。