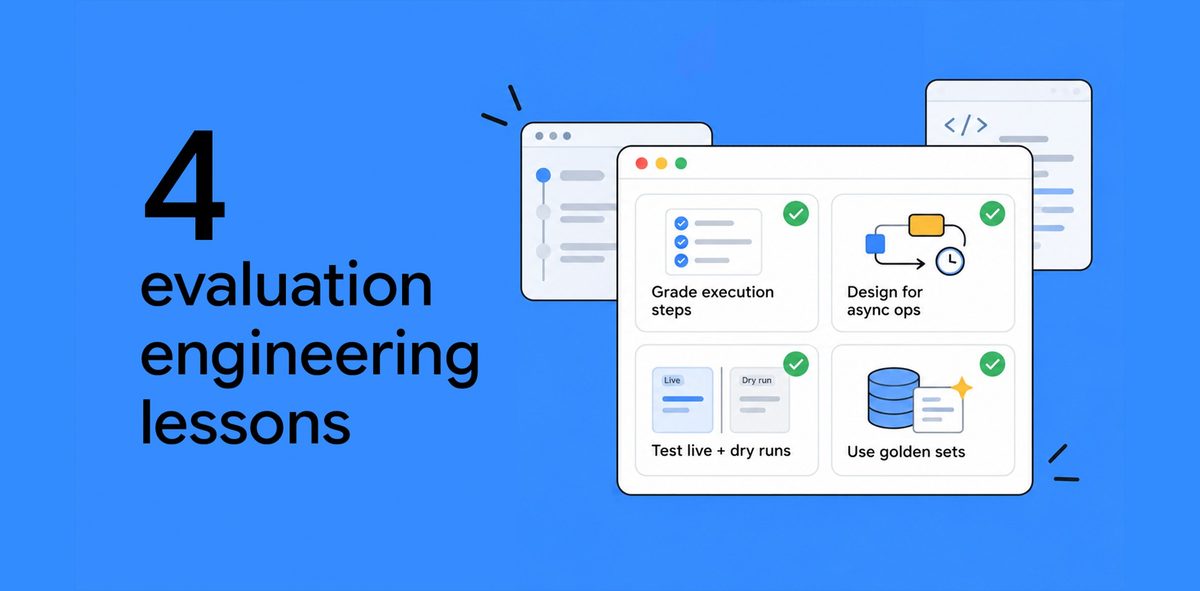
Google:评测工程四课——评轨迹不评终稿、保 turn 结构、live/plan 双跑、人策 golden sets
工程评测Agenttool-call 轨迹golden setGoogle Cloud
一句话结论
用 Google Cloud Developer plugin 实战验证:LLM-as-judge 只看终稿会误杀做对却不「炫耀」的 agent;遥测要保留 turn;live 与 plan-only 并跑;再用专家 golden sets 当持续基线,而不是靠单次炫技 demo。
打开原文
Google Cloud:Four eval engineering lessons
背景与理念
搭 agent 不难,难的是可重复地量出它真正做了什么。扁平事件流和只评最终回复,会把并行 dispatch、技能注入时序和「做对但不写进总结」一起盖住。
具体做法
- 评原始 tool-call 轨迹,不评终稿摘要;初套 11 个 prompts 上,LLM-as-judge 误杀 3 题,轨迹显示全过。
- 遥测保留 turn 结构,避免并行 tool_calls 与 skill 注入时序被压成扁平列表。
- live(真实沙箱凭证执行)与 plan-only(无凭证只规划)并跑;约一半关键发现来自两者差分。
- 用真人专家策展的 golden sets 当整栈(harness + 模型 + 工具)基线,而不是 one-shot demo。
关键数据/例子
11 prompts 初评:终稿裁判误杀 3,轨迹全过。约一半关键发现来自 live/plan 差分;某 onboarding 题 plan-only 产出约 8000 字符计划却无视组织策略与审批。
创新点
第一,把「是否执行了 X」锚定到轨迹,而不是终稿话术。第二,把 live 与 plan-only 差分当成一等评测手段,专门抓被权限错误掩盖的认知缺陷。
可否复用
- 自建 agent eval 当天可改:先接轨迹评分,再接 LLM 终稿裁判。
- 遥测导出保留 turn 与并行 tool_calls 边界。
- 每个关键场景至少跑 live 与 plan-only 两条件,并维护专家 golden sets。