Google:用 CUJ、红笔读迹与 agent-eval 走过 Day0–Day2,把 agent 评测从「看着像」换成可回归的门禁
agent-evalCUJOpenTelemetryLLM-as-judgeCI 门禁
一句话结论
Google 解决方案工程师给出 agent 评测渐进路径:先用关键用户旅程与模拟用户建黄金集并用红笔读迹,再落到布尔量规与 deterministic 检查,最后用开源 agent-eval + Gemini 平台评测服务做每次改动对比与 PR 门禁;强调别删测改基线、别迷信 1–5 分、别只评最终文案而忽略延迟与费用。
打开原文
Google Developers Blog:Evaluating AI agents: moving past the vibe check
背景与理念
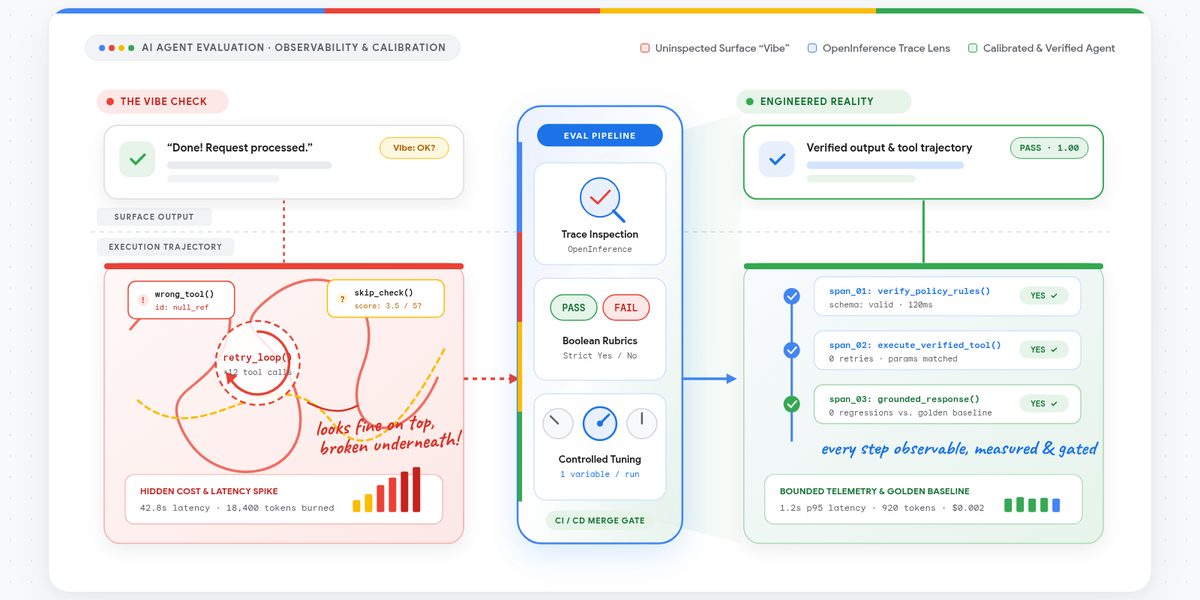
团队起步时常在终端里跑三四个提示,答案看起来合理就上线,一改系统提示就可能在别的流程里漏调工具。Agent 还会卡在重试环、连打工具,却仍返回礼貌、像真的最终答案,从而悄悄抬高账单、打满配额、让用户空转,甚至对外系统制造重复副作用。作者主张评测是渐进旅程:任何可重复体系都好过临场目测;不必第一天就上大而全自动打分。
具体做法
- 用关键用户旅程(CUJ)定义成功。先写清人设、目标、约束与核验条件;例句中每个从句(是否找对交易、是否先查台账、是否在 30 秒内、是否把内部 ID 译回券商命名)都变成评测点。
- Day 0:模拟用户 + 红笔。把 CUJ 拆成场景,用 ADK 用户模拟等生成多轮messy 对话并录完整执行迹;先通读 5–20 条迹,手标犹豫、幻觉参数、错工具、废话,再据此列真正要自动化的断言。
- Day 1:agent-eval 框架与调参环。用开源 agent-eval 脚手架黄金集、对 HTTP 或离线 agent 跑多轮、按 OpenInference 约定收 OpenTelemetry 迹,并接到 Gemini 平台 Agent Evaluation;每次改提示/模型/工具说明都跑同一套测并对比基线。作者称真实部署常要 50–60 次小迭代,每次只拧一个旋钮。
- 量全栈四层。单元测试、deterministic 指标、LLM-as-judge 量规、集成测试分层,避免只看一个总分。
- Day 2:PR 门禁与共享看板。在 Cloud Build / GitHub Actions 无头跑评测:例如全局通过率门槛(文中举例 95% 布尔成功)且核心指标零回归才合并;产物进 BigQuery/Cloud Storage,上线后把真实失败迹回流黄金集。
关键数据/例子
可操作数字与约束来自原文:Day 0 建议先精读约 5–20 条迹;调参环常需约 50–60 次小改;门禁举例为约 95% 布尔通过且核心指标不回归。配套视频号称在约 60 分钟内给真实 LangGraph agent 搭完整流水线。陷阱包括:删测会移动基线而不是证明 agent 变好;1–5 分 judge 边界不稳,应改成「退款前是否核验账户 ID?」这类是否题;只评文案会漏掉 40 秒、十二次冗余工具调用、单次六毛钱这类运营失败。跨框架则靠 OpenInference 语义约定解耦。
创新点
第一,把「红笔读迹」写成 Day 0 硬步骤,用真实失败模式驱动后面的自动化,而不是先写空泛量规。第二,坚持布尔量规 + 运营指标(延迟、token、费用、工具次数)与答案质量并列。第三,用 OpenTelemetry/OpenInference 把评测管道与编排框架解耦,换 LangGraph、ADK 或自研运行时不必重写打分。
可否复用
- 先写 3–5 条 CUJ,再谈框架选型;每条 CUJ 拆成可点名的核验条件。
- Day 0 强制人工读迹,把红笔笔记变成断言清单后再自动化。
- 冻结黄金集再调功能;judge 用是否题,并与人标迹对齐后再信任。
- CI 同时卡「总分门槛」与「核心指标零回归」,并把延迟/费用放进同一报告;上线后定期把生产失败迹升进黄金集。