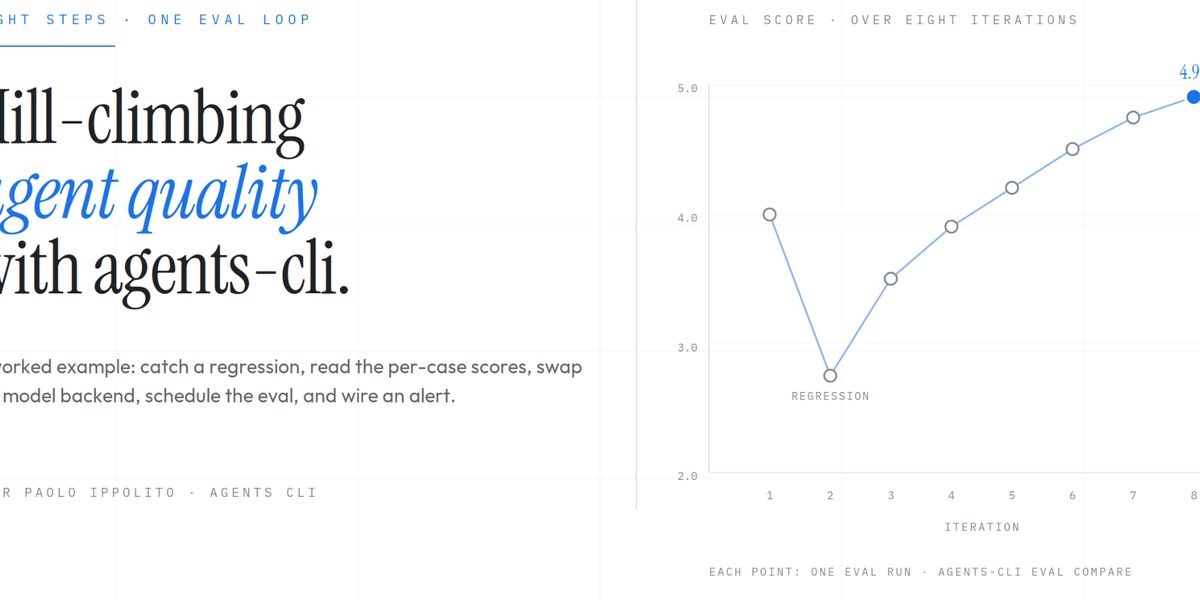
Google Agents CLI:用 generate→grade→compare 爬坡,厨师人设回归均值 4.0→2.75
工程Agent评测Agents CLI回归LLM-as-judgehill-climbing
一句话结论
Demo 能跑不等于换模型/工具后仍稳;用小数据集每次改动都跑 eval generate/grade,再用 compare 看逐案差分与阈值告警,把质量工程做成可重复 hill-climb 环。
打开原文
Google Developers:Hill-Climbing Agent Quality with Agents CLI Evaluation
背景与理念
周末做出能 demo 的 agent,和跨升级仍稳,是两类问题。后者靠写用例→跑→打分→改→再跑;分数升则留,降则撤,质量工程称 hill-climbing。
具体做法
- Agents CLI:eval generate / grade / compare / analyze / optimize(ADK+GEPA)。LangChain 模板自带数据集、配置与自定义 1–5 分 LLM-as-judge(文中用 gemini-3.8-flash)。
- 演示回归:错贴厨师 system prompt,单元测试全过,均值 4.000→2.750;sf_weather 4→2(停调天气工具)。
- 换更便宜后端均值同样掉,但逐案故事不同——off_topic 重挫而 greeting 持平,必须看 case 差分。定时跑 + 均值跌超阈值(例 0.1)非零退出告警;快照整份结果 JSON 而非只存分数。
关键数据/例子
基线 mean 4.000 / stdev 1.414;厨师回归 mean 2.750 / stdev 0.957。受控研究:用 CLI 的 coding agent 跑 eval 约 4× 多,但改 agent 频率未必更高——评测必要,改进来自根据结果行动。
创新点
第一,把小而常跑的数据集当成变更门禁,而不是年底大考。第二,用逐案差分拆穿「均值相同、病因不同」的换模幻觉。
可否复用
- 先做 4–10 条能代表主行为的用例,保证每次改动能跑完。
- 回归对比必须留完整结果文件,才能 compare 到具体 case。
- 告警盯均值跌幅,决策盯逐案;换模与换 prompt 分开做实验。