Google A2UI Express:可插拔推理格式把 gen-UI token/延迟约压到 Direct JSON 的 ≤1/3
工程A2UI生成式UI推理格式Agent SDKDSLGoogle
一句话结论
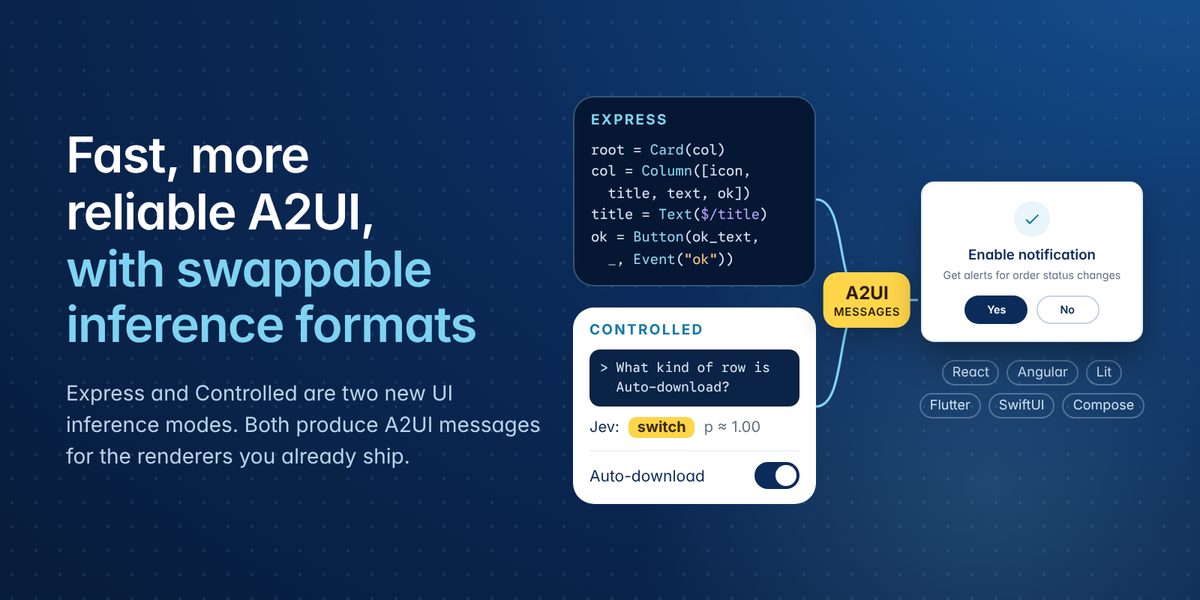
把 inference_format 从传输协议里拆出来,默认用 A2UI Express 让模型写类 Python 单行语句,再由 Agent SDK 确定性编成校验过的 A2UI JSON;相对 Direct JSON 约 ≤3× 少 token、延迟约 ≤3×,已知版式还可走 Jev。
打开原文
Google Developers:Fast, reliable A2UI, with swappable inference formats
背景与理念
直出复杂 JSON schema 又慢又易错,还会把 A2UI 绑死在「会吐文本的 LLM」上。团队要的是生成式 UI 又快又稳,并且推理格式可换。
具体做法
- 可插拔 inference_format,默认 A2UI Express;用法示例:A2uiGenerator(..., inference_format_factory=ExpressFormatFactory())。
- 模型写类 Python 单行语句,SDK 编成校验过的 A2UI JSON;已知版式可走 Jev(System One)控布局,再 lite 填文案。
- 用 51-task eval 对比 Direct JSON / Express / Atom / Elemental。
关键数据/例子
Express 相对 Direct JSON 约 ≤3× 少 token、延迟约 ≤3×;Jev 控布局可达约 80× 量级加速叙述。Apparite 11 prompts:组件树约 92–298 ms 上屏、整屏约 0.8–1.7 s;Jev 单请求约 100–300 ms。
创新点
第一,把推理格式与传输协议解耦,让 gen-UI 不绑定某一种「吐 JSON」的模型习惯。第二,用 DSL→确定性编译换可靠性,而不是靠更大模型硬吐 schema。
可否复用
- 自研 gen-UI 先定「模型写什么 DSL、编译器保证什么」,再谈 prompt。
- 已知版式走布局 DSL + 文案填充,避免每次全树重生。
- 用固定 task 集对比多种 inference_format,而不是只看单次延迟。